GEO: оптимизация для ИИ-поиска
ИИ-движки не ранжируют, а выбирают источники. Делаем сайт цитируемым: llms.txt, структурированные данные, E-E-A-T, политика краулеров и WebMCP.
ИИ-движки не ранжируют страницы. Отвечая на вопрос, система сама выбирает, какие источники прочитать, вплетает взятые оттуда предложения в собственный ответ и часто ставит под ним несколько ссылок. Поэтому цель состоит не в том, чтобы занять третью строчку, а в том, чтобы оказаться среди источников, названных внутри этого ответа. Условия здесь отличаются от условий классического ранжирования: модель должна найти страницу, понять без догадок, о чём она, и получить верный смысл даже тогда, когда вырывает из неё один абзац. Работа Detartech по GEO сводится к тому, чтобы выстроить на сайте эти три условия по очереди. То же самое мы сделали на собственном сайте, поэтому большую часть утверждений на этой странице можно открыть и проверить на detartech.com.
Как мы определяем GEO
GEO расшифровывается как generative engine optimization, то есть подготовка сайта к тому, чтобы он годился в качестве источника для систем, которые отвечают пользователю: ChatGPT, Perplexity, Google AI Overviews. Работа состоит из двух слоёв. Первый слой заключается в машинной читаемости: модель и её краулер находят сайт, понимают, что представляет собой каждая страница, и не вынуждены угадывать при разборе содержимого. Второй слой заключается в цитируемости: абзац остаётся верным, полным и пригодным для ссылки на источник даже после того, как его вынули со страницы. Есть и то, чего мы не делаем: не прячем в разметку инструкции для модели, не пишем невидимый для посетителя текст, не выдумываем авторов и даты. Всё это нарушает рекомендации поисковых систем и заодно быстрее всего разрушает тот самый сигнал доверия. О том, как устроены отвечающие системы и как выглядит техническая дорожная карта, мы написали в руководстве по GEO.
Как мы открываем сайт для ИИ-движков
Шесть заголовков ниже охватывают всё, что входит в работу по GEO. Первые два описывают слой обнаружения и слой смысла: машиночитаемые файлы, по которым модель находит сайт, и структурированные данные, не оставляющие разночтений о том, чем является страница. Третий отвечает на вопрос, кто говорит, четвёртый определяет, какой краулер и ради какой цели вообще заходит. Пятый касается самого текста, то есть пригодности отдельного фрагмента к самостоятельному цитированию. Шестой выходит за пределы чтения: он про инструменты, которые сайт даёт агентам, выполняющим действия. Большинство проектов начинается с первых пяти заголовков.
llms.txt и машиночитаемая карта сайта
Файл llms.txt представляет собой индекс в формате markdown, который лежит в корне сайта и подсказывает модели, к каким адресам обращаться при чтении. Внутрь пишется не копия меню, а реально существующие адреса и по одной строке о том, что находится по каждому из них; единственный несуществующий адрес делает недостоверным весь файл. На том же слое живут JSON-эндпоинты: список услуг, файл частых вопросов, каталог API. Это места, где машина получает ответ, не разбирая страницу, написанную для человека. В карте сайта чаще всего мы исправляем поддельную свежесть, когда при каждой выкладке всем страницам проставляется сегодняшняя дата в lastmod: за считанные недели такая привычка обесценивает всю информацию о датах на сайте. Вместо того чтобы ждать очередного обхода изменившейся страницы, мы сообщаем о ней напрямую через IndexNow.
Структурированные данные Schema.org
Структурированные данные представляют собой блок JSON-LD, который объясняет машине, чем является страница. Для сведений о компании мы используем Organization, для сайта в целом WebSite, для записи в блоге Article, для пошаговой инструкции HowTo, для блока вопросов и ответов FAQPage, для навигационной цепочки BreadcrumbList. Незаметная часть работы состоит в связывании сущностей: если название компании на сайте, её адрес и профили во внешних источниках не связаны через sameAs, модель может решить, что речь идёт о двух разных организациях. Одно правило обсуждению не подлежит: разметка обязана совпадать с текстом, видимым на странице. Отметка FAQPage на вопросах, которых на странице нет, приносит не видимость, а санкции. Каждую схему мы прогоняем через валидатор до публикации, потому что одно испорченное поле способно оставить нечитаемым весь блок.
Сигналы E-E-A-T
Аббревиатура E-E-A-T расшифровывается как experience, expertise, authoritativeness и trustworthiness, то есть опыт, компетентность, авторитетность и надёжность: именно по этим сигналам поисковые системы судят, можно ли доверять содержанию. Отвечающие системы рассуждают похожим образом и прежде чем процитировать фразу смотрят, кто её произнёс. Поэтому страница автора ведёт к реальному человеку, к его настоящей специализации и к способу с ним связаться; даты публикации и обновления проставляются честно; а если утверждение опирается на внешний источник, этот источник называется прямо в тексте. Со стороны компании юридическое наименование, адрес и контакты держатся одинаковыми на всех страницах, потому что по-разному написанное название ослабляет сигнал идентичности. Часть работы под этим заголовком лежит не на нас, а на вас: без настоящих авторов, настоящего опыта и проверяемых кейсов такие сигналы не производятся.
Политика доступа ИИ-краулеров и robots.txt
Здесь robots.txt является не технической мелочью, а коммерческим решением: какой краулер и ради чего попадает на ваш сайт. Разделить нужно три группы. Одни собирают контент для обучения моделей, другие питают поисковый индекс, третьи открывают страницу от имени пользователя в тот момент, когда он задал вопрос. Закрыть обучающий краулер и оставить открытым того, кто приходит во время ответа, значит занять последовательную позицию; закрыть все три группы значит закрыть заодно и шанс попасть в ответы. Решение мы фиксируем письменно, а затем прописываем правила поимённо для каждого краулера, потому что политика, оставленная на усмотрение звёздочки, потом делает спорным вопрос, кому и что было разрешено. Ещё одно обстоятельство: robots.txt не всегда является тем файлом, который написали вы. Управляемые блоки, добавленные слоем CDN, могут стоять выше ваших собственных правил, поэтому политику мы проверяем по живому файлу, а не по репозиторию.
Архитектура цитируемых фрагментов
Отвечающая система забирает не страницу целиком, а один её раздел. Поэтому блок под каждым заголовком обязан быть самодостаточным: ответ даётся первым предложением, определение идёт раньше подробностей, число стоит в одном предложении со своей единицей и своей датой, а отсылки назад вроде «как мы объясняли выше» не используются вовсе. Проверка простая: вырежьте абзац со страницы и прочитайте его отдельно, остаётся ли он верным и понятным? Если нет, этот абзац никогда не попадёт внутрь ответа. Блок частых вопросов пишется по той же логике, и берётся в нём тот вопрос, который покупатель задаёт на самом деле, а не украшающий текст маркетинговый. Сама эта страница тоже построена по такому правилу.
WebMCP и агенты, которые пользуются сайтом
Агенты уже не только читают сайты, но и выполняют на них действия. WebMCP представляет собой подход, при котором сайт предлагает пришедшему агенту не текст для разбора, а инструменты, вызываемые напрямую. На нашем собственном сайте эти инструменты не объявляются вручную второй раз: агент в браузере берёт список инструментов у собственного MCP-эндпоинта сайта, и потому две поверхности не могут разойтись. Все зарегистрированные инструменты работают только на чтение. Формы контакта и запроса предложения при этом остаются открытыми как декларативные инструменты формы, благодаря чему перед отправкой человек по-прежнему находится перед формой. Каталог API по RFC 9727 отдельно сообщает машинам, какие интерфейсы вообще существуют. Скажем честно: сегодня WebMCP работает только в Chrome и только в пробном режиме, поэтому мы не продаём его как обещание трафика, а строим как слой, который готовит завтрашний интерфейс уже сейчас. Подробности собраны в нашей статье о WebMCP.
Чем GEO отличается от SEO и где они пересекаются
SEO борется за место в списке из десяти синих ссылок, а GEO борется за то, чтобы оказаться среди немногих источников, которые модель читает, составляя ответ. Пересечение шире, чем принято думать: доступность для обхода, скорость страницы, корректный HTML, аккуратная карта сайта, разумная внутренняя перелинковка и содержание, действительно несущее информацию, служат общей опорой обеим сторонам. Сайт, которого не видит Googlebot, в значительной мере невидим и для ИИ-краулеров, поэтому GEO мы не продаём как замену SEO. Расхождение начинается в двух местах. Первое касается единицы работы: SEO оптимизирует страницу, GEO оптимизирует фрагмент, а значит решает не плотность ключевых слов, а полнота отдельного абзаца. Второе касается результата: ответ ИИ способен удовлетворить пользователя без перехода, и число сессий само по себе перестаёт быть мерой успеха. Техническая работа и архитектура контента на стороне классического поиска вынесены в отдельную услугу и описаны на странице SEO.
Как мы измеряем видимость
Измерение мы делим на четыре слоя. Первый слой охватывает обход: по логам сервера и CDN видно, какой ИИ-краулер какие адреса забирал, как часто и с каким кодом ответа. Этот слой представляет собой запись, а не оценку. Второй слой охватывает цитирование: постоянный список вопросов, относящихся именно к вашему делу, с заданной периодичностью прогоняется через отвечающие системы, и фиксируется, встречается ли бренд в ответе и дана ли на него ссылка. Третий слой охватывает переходы: трафик из отвечающих систем ведётся в аналитике отдельным сегментом. Четвёртый слой охватывает конверсию: заполнили ли такие сессии форму, запросили ли предложение. Ограничение второго слоя мы называем заранее. Ответы меняются в зависимости от пользователя, сессии, региона и версии модели, поэтому измеряем мы не позицию, а тенденцию, читаемую по повторяющимся прогонам. Как собирается панель и какие показатели мы ведём, разобрано в статье об измерении видимости в ИИ.
Факторы, определяющие результат
Ответ поисковой системы на один и тот же вопрос не постоянен: он меняется в зависимости от пользователя, сессии, региона и версии модели, работающей в данный момент. Изменение может дойти до краулеров, забирающих страницу в момент ответа, в течение нескольких дней; попадание того же изменения в саму обученную модель зависит от цикла её выпуска. Из-за этой изменчивости мы строим измерение не как разовую проверку, а как регулярно повторяющийся прогон: фиксированный список вопросов запускается по расписанию, и результат читается не как мгновенный снимок, а как тенденция, видимая по повторным прогонам. Разметка тоже не меняет этот механизм, она лишь облегчает модели чтение уже существующей информации: если в абзаце нет ничего, чего нет ещё в двадцати других страницах, никакая схема сама по себе не сделает его цитируемым.
Как устроена работа по GEO
Работа начинается с аудита. Мы смотрим, что действительно опубликовано: robots.txt, карта сайта, llms.txt, проходят ли схемы валидацию, есть ли у нас доступ к логам краулеров и какие вопросы будут измеряться. На выходе получается письменный список, упорядоченный по стоимости и влиянию, и этот список сам по себе представляет собой законченную работу, которую можно забрать и отдать своей команде. Второй этап состоит во внедрении: файлы и разметка попадают в ваш репозиторий и на ваш домен, а не в посредника, стоящего на наших серверах. Идём двухнедельными циклами, и в конце каждого цикла вышедшие изменения отчитываются вместе с результатом измерения. Третий этап состоит в измерении: до внедрения снимается базовый замер, после внедрения тот же список вопросов повторяется. Когда работа заканчивается, ничего не выключается: llms.txt, схемы и правила robots остаются на вашем сайте, а список вопросов и таблица измерений передаются вам.
Ежемесячные планы GEO
GEO не заканчивается как разовый проект: ответные движки, модели и контент конкурентов меняются каждый месяц. Поэтому после аудита и первого этапа внедрения мы продолжаем работу по ежемесячному плану. Планов три, и каждый следующий строится на предыдущем. Выбор зависит от того, может ли ваша команда сама внедрять найденное и хотите ли вы связать спрос из ИИ-поиска с продажами. Объём работ в каждом плане фиксирован, цена определяется в коммерческом предложении с учётом размера сайта, числа языков и количества отслеживаемых вопросов.
Мониторинг: измеряем и отчитываемся
- Начальный аудит и зафиксированная базовая точка, с которой сравниваются все последующие измерения
- Фиксированный список вопросов по вашему бизнесу, который каждый месяц прогоняется несколько раз в ChatGPT, Perplexity, Gemini и Google AI Overviews
- Доля цитирования (share of voice) и список вопросов, где цитируют конкурентов, но не вас (citation gap)
- Отслеживание трёх выбранных вами конкурентов по тем же вопросам и в классическом поиске
- Анализ логов сервера и CDN: какие страницы и как часто запрашивают ИИ-краулеры
- Трафик из ответных движков как отдельный сегмент в GA4 и Search Console
- Ежемесячный отчёт, в котором находки упорядочены по стоимости и эффекту
Мониторинг и внедрение: измеряем и исправляем
Всё, что входит в план «Мониторинг», плюс внедрение находок с нашей стороны. В этом отличие от услуги, которая только присылает отчёты: пробел, найденный в одном отчёте, в следующем уже отмечен как закрытый.
- Фиксированный ежемесячный объём инженерной работы для внедрения находок в вашем репозитории: структурированные данные, llms.txt, политика robots.txt, sitemap и IndexNow
- Переработка фрагментов на страницах, соответствующих нецитируемым вопросам, чтобы их можно было цитировать отдельно, и упорядочивание внутренних ссылок
- Ежемесячная техническая проверка: PageSpeed и Core Web Vitals, битые ссылки, ошибки индексации и редиректов
- Обновление или написание одного-двух руководств каждый месяц
Рост: измеряем, исправляем и связываем с выручкой
Всё, что входит в план «Мониторинг и внедрение», плюс внешний авторитет и связь спроса из ИИ-поиска с продажами. Значительная часть страниц, на которые ссылаются ответные движки, находится не на сайте бренда, поэтому этот план выходит за пределы вашего сайта.
- Создание и обновление профилей с реальными данными о проектах в каталогах и на платформах, которые ответные движки часто цитируют
- Процесс предложения экспертных статей и комментариев отраслевым изданиям
- Управление профилем Google Business и процесс запроса отзывов клиентов без вознаграждения
- Отслеживание сессий из ответных движков до формы, CRM и коммерческого предложения; эта часть строится на нашей инфраструктуре RevOps
- Ежемесячный отчёт «какой движок, сколько заявок, какие предложения» и стратегическая встреча раз в квартал
Что общего у всех планов
Ежемесячный отчёт во всех планах состоит из четырёх разделов: что сделано за месяц, видимость в ИИ и результаты в поиске, положение конкурентов и план на следующий месяц. Первый месяц уходит на настройку доступов и фиксацию базовой точки, сравнение имеет смысл со второго месяца. В конце двенадцатого месяца аудит проводится заново, и результат сопоставляется с базовой точкой первого дня. Ни один план не гарантирует появления в конкретном ответе. Вы получаете другое: каждый месяц письменную фиксацию того, что измерено, что изменилось и что сделано.
Чтобы понять, какой план вам подходит, можно начать с бесплатного предварительного анализа: мы прогоняем десять вопросов о вашем бренде в четырёх ответных движках и письменно сообщаем, где вас цитируют, где вместо вас появляются конкуренты, и три самых крупных технических пробела. Запрос можно отправить через форму быстрого запроса.
Что можно проверить со стороны
Каждый пункт ниже работает прямо сейчас и проверяется извне.
- detartech.com, машиночитаемый слой: опубликованы llms.txt, каталог API по RFC 9727, ai/service.json и .well-known/ai.txt. Кроме того, клиенту, запросившему markdown, та же самая страница отдаётся в формате markdown, а не в HTML.
- detartech.com, интерфейс для агентов: инструменты WebMCP регистрируются из списка инструментов собственного MCP-эндпоинта сайта, и все они работают только на чтение. Формы контакта и запроса предложения открыты как декларативные инструменты формы, поэтому перед отправкой человек остаётся перед формой.
- SanalRandevu: опубликованы llms.txt, правила robots.txt с поимённым перечислением 18 ИИ-краулеров, структурированные данные Organization, WebSite и HowTo, а также быстрая индексация через IndexNow.
- bebekistiyorum.com: архив контента более чем из 1200 URL на 4 языках оптимизирован не только под классическую выдачу, но и под поиск с помощью ИИ в ChatGPT и Perplexity.
Преимущества
- llms.txt, машиночитаемые эндпоинты и честная гигиена карты сайта
- Структурированные данные Schema.org, совпадающие с видимым текстом
- Сигналы E-E-A-T на основе авторства, источников и дат
- Политика доступа ИИ-краулеров в robots.txt по цели обхода
- Архитектура фрагментов, пригодных к самостоятельному цитированию
- Измерение из четырёх слоёв: обход, цитирование, переходы, конверсия
- Три ежемесячных плана с фиксированным объёмом: «Мониторинг», «Мониторинг и внедрение», «Рост»
Часто задаваемые вопросы
Сколько длится работа по GEO и как формируется цена?
Какой ежемесячный план GEO выбрать?
Гарантируете ли вы попадание в ответы ChatGPT или Perplexity?
Что мы передаём по завершении работы?
У нас уже есть SEO. Нужен ли GEO отдельно?
А нельзя ли просто закрыть все ИИ-краулеры?
Нужен ли нам WebMCP?
Где мы оказываем эту услугу
 GEO для контента на турецком языке
 GEO для международных продуктов из Виттена
 GEO для образовательных платформ из Солихалла
Как мы предоставляем эту услугу
Технологии, которые мы используем
Смотреть все
llms.txt
Стандартный текстовый файл, добавляемый в корневой каталог, чтобы ИИ-модели лучше понимали веб-сайт. ИИ-аналог robots.txt.
OpenAI
Платформа для разработки корпоративных ИИ-приложений с помощью API GPT-4o, o1 и Embeddings. Единый API-доступ к текстовым, кодовым, графическим и аудиомоделям.
Perplexity
ИИ-поисковая система, выполняющая поиск в интернете в реальном времени с указанием источников. Критически важная платформа для видимости в стратегии GEO; интегрируется в приложения через Sonar API.
Другие проекты
Смотреть все
Paşa Yapı Tasarım - Корпоративный сайт фасадных и отделочных решений
Двуязычный (TR/EN) корпоративный сайт для Paşa Yapı Tasarım, стамбульской компании по фасадам, интерьерам, потолкам и полам с 1992 года. 22 страницы услуг, 6-шаговый мастер заявки, электронный каталог и SEO для AI-поиска.

bebekistiyorum.com: многоязычный сайт клиники ЭКО, SEO и GEO
Сайт клиники ЭКО Eurofertil на ASP.NET перестроен на Next.js на 4 языках: более 1200 URL сохранены 301-редиректами, выстроена SEO- и GEO-инфраструктура.
Yükpro - Платформа грузоперевозок
Мы превратили прототип Yükpro, созданный с помощью ИИ, в готовый к продакшену MVP платформы, объединяющей грузовладельцев и перевозчиков, и запустили его на iOS и Android.
Похожие статьи
ChatGPT Ads открылась в Турции: как реклама OpenAI дошла из США до 56 стран и как её запустить
Рекламная система OpenAI открылась в Турции 16 сентября 2026 года. Хронология запуска, форматы chat_card и Sponsored Agents, цены CPM/CPC и чек-лист аккаунта.
Эпоха нулевых кликов: как AI Overviews меняют органический трафик
Больше двух третей поисковых запросов Google в США теперь заканчиваются без клика. SEO не умерло, но то, что вы измеряете, придётся поменять.
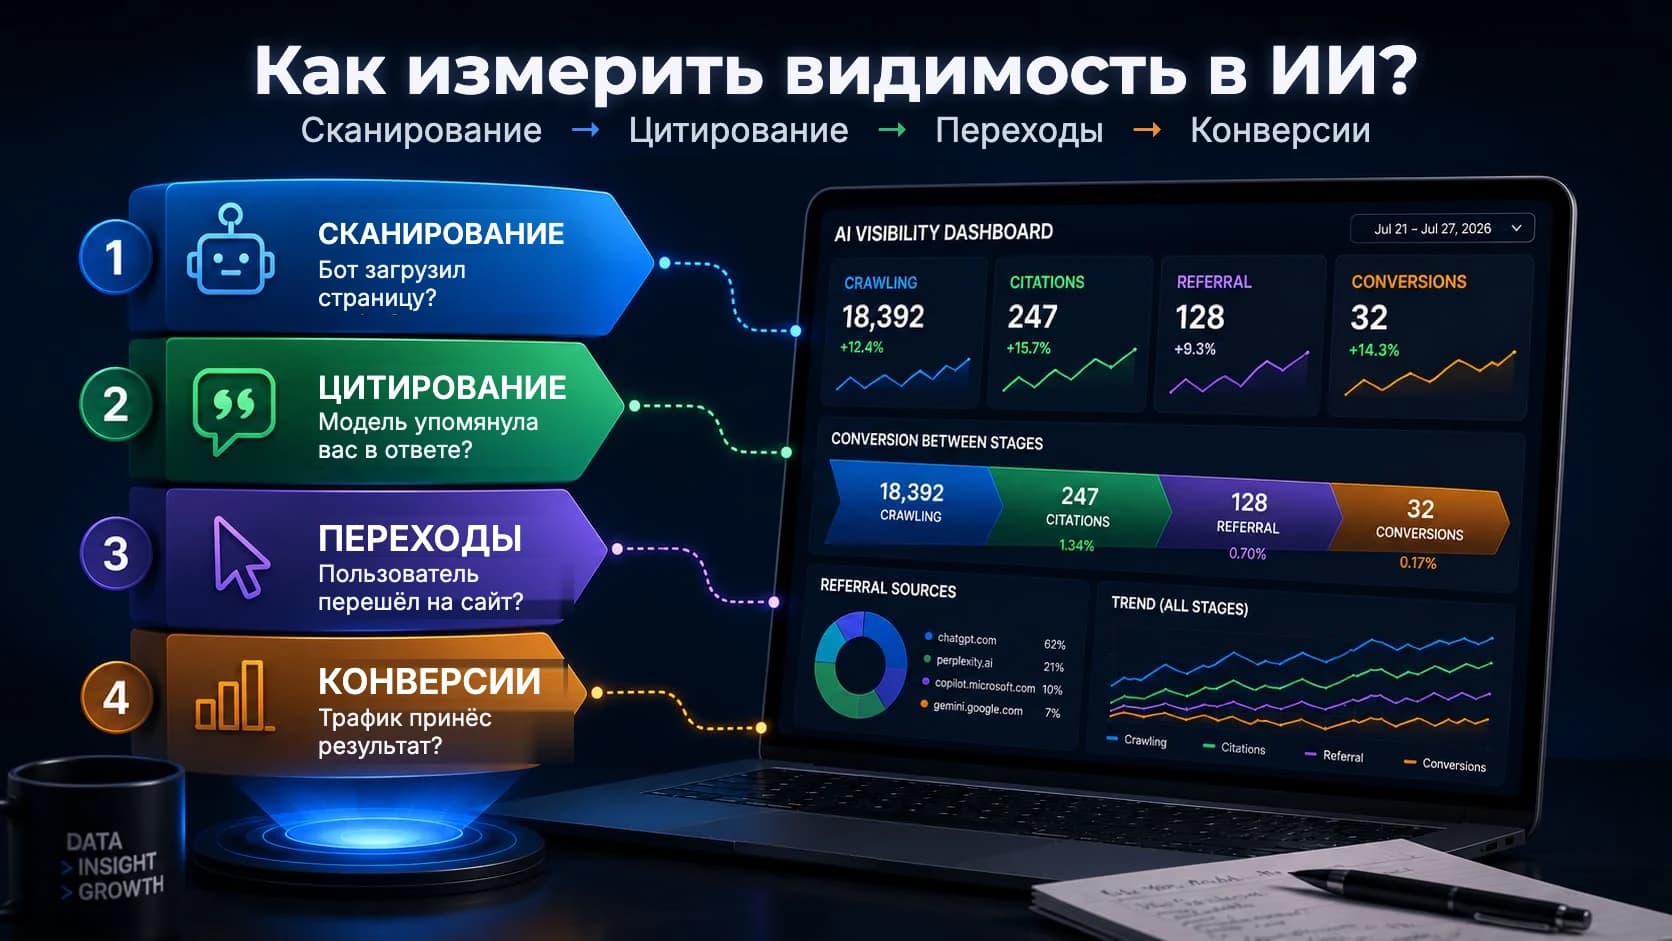
Измерение видимости в AI: GEO KPI и панель мониторинга
Видны ли вы в ответах AI и откуда вы это знаете? GEO KPI по четырём слоям: обход, цитирование, переходы и конверсия, плюс построение панели мониторинга.
Руководство по GEO для AI-поисковых систем: техническая дорожная карта видимости в ChatGPT, Perplexity и Gemini
Что такое GEO (Generative Engine Optimization) и чем оно отличается от SEO? Действительно ли работает llms.txt? Технический гид 2026 года с Schema.org, WebMCP и готовыми примерами кода для копирования.
WebMCP: Когда ИИ-агенты работают с твоим сайтом не кликами, а словами
Строка «agentic browsing», которую я заметил в отчёте PageSpeed, оказалась дверью в будущее веба. Что такое WebMCP, чем он отличается от MCP и почему тебе стоит задуматься об этом уже сейчас с точки зрения SEO и GEO? Рассказываю с технической точки зрения, с примерами кода.
Обсудим ваш проект
Как применить эту услугу к вашему проекту?
Заполните форму заявки для бесплатной 30-минутной консультации.