GEO (Generative Engine Optimization) представляет собой практику структурирования контента так, чтобы генеративные AI-модели, такие как ChatGPT, Gemini и Perplexity, могли легко его читать и указывать как источник в своих ответах. GEO не заменяет SEO, а служит дополнительным уровнем поверх него; основные инструменты: четкие блоки определений, схема FAQPage/DefinedTerm, сравнительные таблицы, контент с серверным рендерингом (SSR) и, при правильно выставленных ожиданиях, файл llms.txt.
Часть читателей этой статьи не люди.
Мы начинаем со смелого утверждения, потому что это уже реальность: ChatGPT, Perplexity и AI-обзоры Google сканируют, читают и обобщают сайты от имени пользователя. Какой бренд привести в пример, какое предложение указать как источник, какой сайт считать "надежным": это решение теперь принимает не позиция в результатах поиска, а языковая модель.
Эта статья делает две вещи. Сначала она проясняет, что такое GEO (Generative Engine Optimization) и что в этой сфере реально, а что является маркетинговым преувеличением: в этой области циркулирует множество заявлений и очень мало проверенных данных. Затем, с помощью примеров кода, которые можно сразу скопировать и использовать, она делает ваш сайт рабочим как для людей, так и для ботов.
Быстрый ответ: GEO представляет собой практику структурирования контента так, чтобы большие языковые модели (LLM) могли легко его читать и указывать как источник в своих ответах. Основные инструменты: четкие блоки определений, схема
FAQPage/DefinedTerm, сравнительные таблицы, контент, отрендеренный на стороне сервера (SSR), и, при правильно выставленных ожиданиях, файлllms.txt. Сама эта статья применяет описываемые в ней техники.
Содержание
- Что такое GEO и почему именно сейчас?
- Как AI-боты читают ваш сайт?
- Сравнение GEO и SEO
- Действительно ли работает llms.txt? (честный ответ)
- Структурированные данные с помощью Schema.org
- WebMCP: следующий уровень
- Глоссарий терминов
- Часто задаваемые вопросы
- Контрольный список внедрения
Что такое GEO и почему именно сейчас?
GEO (Generative Engine Optimization): практика структурирования контента так, чтобы генеративные AI-модели, такие как ChatGPT, Gemini и Perplexity, могли использовать его как источник в своих ответах.
Цель SEO заключалась в том, чтобы занимать верхние позиции в результатах поиска. Цель GEO немного иная: чтобы AI, отвечая на вопрос, ссылался на ваш бренд, ваши данные или вашу формулировку. Эти два подхода не исключают друг друга: GEO является дополнительным уровнем, построенным поверх SEO, а не заменой ему.
Почему именно сейчас. Поведение пользователей меняется. Поиск больше не предлагает только "10 синих ссылок". Google AI Overviews, поисковый режим ChatGPT и такие инструменты, как Perplexity, дают пользователю прямой, синтезированный ответ на его вопрос: во многих случаях пользователь завершает поиск, вообще не переходя ни на один сайт. В индустрии это называют тенденцией "zero-click" (нулевой клик).
Практический вывод таков: то, что ваш сайт занимает высокие позиции в Google, по-прежнему важно, но теперь появился и другой вопрос: "Когда у ChatGPT спрашивают 'посоветуй агентство по рекламе в Meta в Стамбуле', звучит ли там ваше имя?" Это разные игры, и в обе стоит играть.
Как AI-боты читают ваш сайт?
Что происходит, когда AI-бот посещает ваш сайт? У каждой крупной AI-компании есть собственный бот (user-agent): GPTBot и OAI-SearchBot (OpenAI), ClaudeBot (Anthropic), PerplexityBot (Perplexity), Google-Extended (Google). Эти боты сканируют вашу страницу, читают HTML и включают контент либо в обучение модели, либо в генерацию ответа в реальном времени (retrieval).
Является ли контент, созданный с помощью JavaScript, проблемой? Обычно да. Большинство AI-ботов не обладают такими продвинутыми возможностями рендеринга JavaScript, как Googlebot. Ваш критически важный текст должен быть читаемым в HTML, отрендеренном на стороне сервера (SSR), даже без выполнения JavaScript. Проверить это легко: щелкните правой кнопкой мыши на странице → "Просмотреть исходный код страницы" и посмотрите, видите ли вы искомый текст невооруженным глазом.
Какие предложения боты считают "достойными цитирования"? Самодостаточные, четкие предложения, на которые можно сослаться. Не расплывчатые формулировки вроде "по этому поводу существуют разные мнения", а определения, которые полностью раскрываются в одном предложении, например: "GEO представляет собой практику структурирования контента так, чтобы AI-модели могли использовать его как источник в своих ответах".
Сравнение GEO и SEO
| Критерий | Традиционное SEO | GEO |
|---|---|---|
| Цель | Занять верхние позиции в результатах поиска | Быть указанным как источник/цитата в ответах AI |
| Критерий успеха | Позиция в выдаче, показатель кликабельности (CTR), органический трафик | Частота цитирования, упоминание бренда в ответах AI |
| Формат контента | Насыщенные ключевыми словами длинные статьи | Четкие, самодостаточные абзацы с прямым ответом |
| Технический приоритет | Обратные ссылки, скорость страницы, Core Web Vitals | Структурированные данные (schema.org), четкие определения, SSR |
| Инструмент измерения | Google Search Console, Analytics, Ahrefs/Semrush | Пока не сформировался: отслеживание упоминаний бренда, ручное тестирование |
| Сигнал актуальности | Достаточно периодических обновлений | Видимая дата "последнее обновление", частые пересмотры |
Действительно ли работает llms.txt? (Честный ответ)
Большинство руководств по GEO описывают llms.txt как "волшебный ключ, который привлекает AI-ботов на ваш сайт". Данные говорят об обратном, и знание этой разницы выделит вас на фоне большинства конкурентов.
Что такое llms.txt? Файл в формате Markdown, расположенный в корневом каталоге вашего сайта (/llms.txt), который рассказывает AI-системам, что представляет собой ваш сайт и какие его страницы наиболее важны. Предложен в 2024 году Джереми Ховардом (Answer.AI) по образцу robots.txt.
Реальность такова: анализ 300 тысяч доменов показал, что файл llms.txt есть примерно у одного из десяти сайтов: это низкий уровень внедрения, несмотря на восемнадцать месяцев обсуждений в индустрии. Еще более показательно: в независимом анализе, охватившем сотни миллионов посещений AI-ботов, количество прямых запросов этого файла со стороны поисковых/ответных ботов (GPTBot, ClaudeBot, PerplexityBot, Google-Extended) осталось на уровне статистического шума. Гэри Иллис (Gary Illyes) из Google летом 2025 года подтвердил, что Google не поддерживает llms.txt и не планирует этого делать; Джон Мюллер (John Mueller) сравнил этот файл с тегом "meta keywords", от которого мир SEO давно отказался.
Иначе говоря: установка llms.txt не сделает вас видимыми в ответах ChatGPT завтра же. Мы хотели сказать это прямо, потому что немало материалов утверждают обратное.
Так почему же мы все равно рекомендуем его? Потому что его реальная ценность лежит в другом: в инструментах для разработчиков. Такие кодовые ассистенты, как Cursor, Windsurf, Claude Code и GitHub Copilot, при обращении к сайту документации рутинно ищут файл /llms.txt. Компании с подходом API-first, такие как Stripe, Cloudflare и Anthropic, публикуют этот файл не ради SEO, а ради удобства разработчиков. Для компании вроде Detartech, ориентированной на разработку ПО и AI, это недорогая, безрисковая инвестиция в инфраструктуру: сегодня она не приносит трафика, но в тот день, когда какой-нибудь AI-провайдер решит воспринимать этот файл всерьез, вы уже будете готовы.
Пример файла (https://detartech.com/llms.txt; адаптируйте под ваши реальные URL-адреса):
# Detartech Technology
 > Программная консалтинговая компания со штаб-квартирой в Турции. Предлагает разработку MVP, CTO as a Service,
> мобильные приложения, AI-решения и услуги DevOps.
 ## Основные страницы
- [Услуги](https://detartech.com/ru/услуги): Разработка ПО, мобильные приложения, AI и услуги DevOps
- [Блог](https://detartech.com/ru/blog): Технические статьи о SEO, GEO и разработке ПО
- [CTO as a Service](https://detartech.com/ru/услуги/cto-as-a-service): Консультации по техническому лидерству и стратегии
 ## Примечания
- Основной контент публикуется на турецком языке, русскоязычные версии находятся в разделе /ru/
- Последнее обновление: 2026-07-01
Дополнительный шаг: проверьте robots.txt: независимо от llms.txt, убедитесь, что вы случайно не блокируете AI-ботов:
User-agent: GPTBot
Allow: /
 User-agent: OAI-SearchBot
Allow: /
 User-agent: ClaudeBot
Allow: /
 User-agent: PerplexityBot
Allow: /
 User-agent: Google-Extended
Allow: /
 Sitemap: https://detartech.com/sitemap.xml
Структурированные данные с помощью Schema.org
Структурированные данные (JSON-LD) явно сообщают ботам, что представляет собой ваша страница: статью, раздел FAQ или определение. Ниже три примера; добавьте их на страницу внутри тега <script type="application/ld+json">:
FAQPage (для вашего раздела FAQ; точно соответствует разделу FAQ ниже):
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [
    {
      "@type": "Question",
      "name": "Заменяет ли GEO SEO?",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "Нет. GEO является дополнительным уровнем, построенным поверх SEO. Ваша техническая основа SEO по-прежнему актуальна; GEO добавляет к этому измерение понятности и цитируемости контента для AI."
      }
    },
    {
      "@type": "Question",
      "name": "Стоит ли устанавливать llms.txt?",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "Да, но не ожидая мгновенного роста трафика. Его главная ценность заключается в инструментах для разработчиков и будущей поддержке платформ."
      }
    }
  ]
}
DefinedTermSet (для вашего глоссария терминов):
{
  "@context": "https://schema.org",
  "@type": "DefinedTermSet",
  "name": "Глоссарий терминов GEO от Detartech",
  "hasDefinedTerm": [
    {
      "@type": "DefinedTerm",
      "name": "GEO",
      "description": "Практика структурирования контента так, чтобы генеративные AI-модели могли использовать его как источник в своих ответах."
    },
    {
      "@type": "DefinedTerm",
      "name": "llms.txt",
      "description": "Markdown-файл в корневом каталоге сайта, который сообщает AI-системам, какие страницы сайта наиболее важны."
    }
  ]
}
Article (для самой статьи блога):
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Руководство по GEO для AI-поисковых систем",
  "datePublished": "2026-07-01",
  "dateModified": "2026-07-01",
  "author": {
    "@type": "Organization",
    "name": "Detartech Technology"
  }
}
WebMCP: следующий уровень
Если llms.txt служит файлом-идентификацией, который рассказывает, "кто вы", то WebMCP представляет собой уровень возможностей, который рассказывает, "что вы умеете делать".
WebMCP (Web Model Context Protocol) является браузерным API, который разрабатывают Google и Microsoft в рамках W3C Web Machine Learning Community Group. В отличие от серверного MCP (Model Context Protocol) от Anthropic, WebMCP работает полностью на стороне клиента, внутри браузера, и предоставляет новый JavaScript-интерфейс под названием navigator.modelContext.
Разница вполне конкретна: сегодня, попадая на ваш сайт, AI-агент делает снимок экрана и пытается угадать, на какую кнопку нажать. На сайте с поддержкой WebMCP агент вместо этого может напрямую вызывать функции, которые сайт предоставляет сам: "создать запись", "узнать цену", "связаться через WhatsApp". Никаких догадок, только прямой вызов.
Если учесть кампании по лидогенерации и работе с WhatsApp, которые вы ведете для клиентов Detartech, этот уровень представляет интересную возможность в среднесрочной перспективе: пока браузерный агент выполняет от имени пользователя задачу вроде "найди надежную компанию, предоставляющую эту услугу, и свяжись с ней через WhatsApp", сайт с поддержкой WebMCP может напрямую удовлетворить этот запрос, не угадывая, как заполнить форму.
Будем реалистами: спецификация пока находится на стадии черновика W3C Community Group, а не официального стандарта. Поддержка браузерами ограничена (экспериментальное превью в Chrome, поддержки от Firefox и Safari пока нет). Разумный график: "наблюдать и изучать" во второй половине 2026 года, "запустить пилот" в 2027 году.
Глоссарий терминов
- GEO (Generative Engine Optimization): практика структурирования контента так, чтобы генеративные AI-модели могли использовать его как источник в своих ответах.
- SEO (Search Engine Optimization): практика оптимизации контента для того, чтобы он занимал более высокие позиции в традиционных поисковых системах.
- LLM (Large Language Model): общее название больших языковых моделей, таких как ChatGPT, Claude и Gemini.
- RAG (Retrieval-Augmented Generation): подход, при котором модель в реальном времени извлекает информацию из веба или базы данных и включает ее в ответ.
- Crawler / Bot / User-Agent: программное обеспечение, которое автоматически посещает веб-страницы и собирает контент. У каждой AI-компании есть собственное название user-agent (GPTBot, ClaudeBot и т.д.).
- Структурированные данные (Structured Data / Schema.org): блок кода, обычно в формате JSON-LD, который явно указывает машинам тип и смысл содержимого страницы.
- llms.txt: Markdown-файл в корневом каталоге сайта, который сообщает AI-системам, какие страницы сайта наиболее важны.
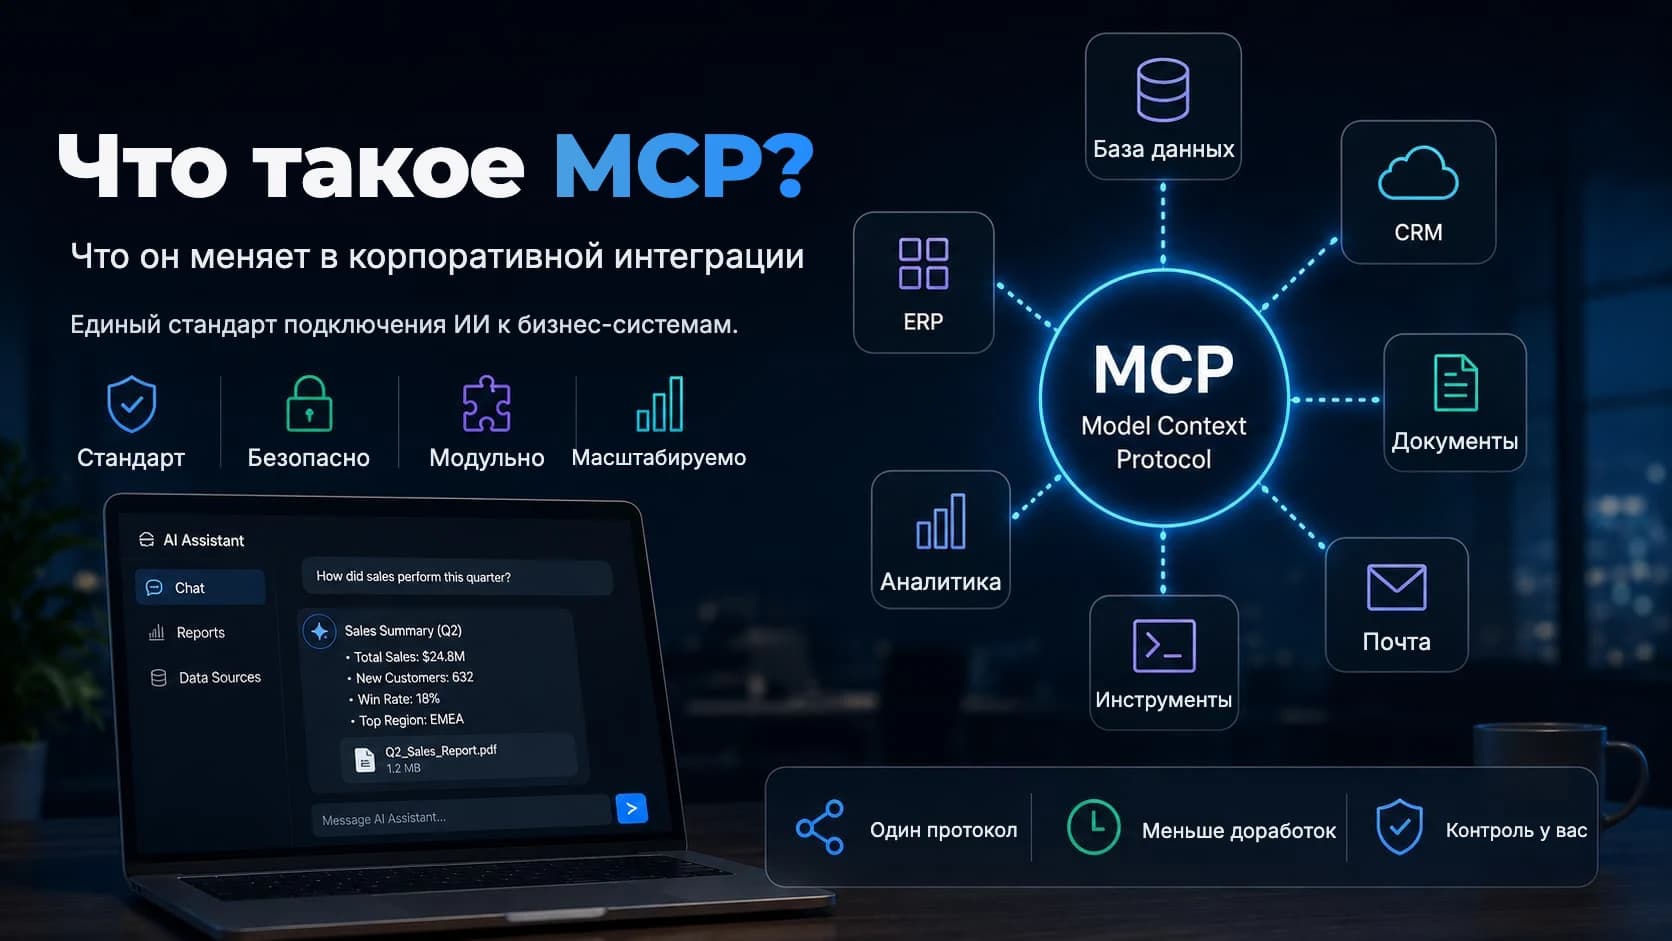
- MCP (Model Context Protocol): открытый серверный протокол, разработанный Anthropic, который соединяет AI-модели с внешними источниками данных и инструментами.
- WebMCP: версия MCP, перенесенная в браузер; черновой стандарт W3C, который позволяет веб-сайтам предоставлять собственные функции AI-агентам в виде напрямую вызываемых инструментов.
- E-E-A-T: критерии Google для оценки качества контента: опыт, экспертность, авторитетность, надежность (Experience, Expertise, Authoritativeness, Trustworthiness).
Часто задаваемые вопросы
Заменяет ли GEO SEO? Нет. GEO является дополнительным уровнем, построенным поверх SEO. Основа технического SEO (скорость, адаптивность под мобильные устройства, обратные ссылки, архитектура сайта) по-прежнему важна; GEO добавляет к этому измерение понятности и цитируемости контента для AI.
Стоит ли устанавливать llms.txt? Да, но с правильными ожиданиями: это не гарантия мгновенного роста трафика из AI-поиска. Это недорогая инвестиция в инструменты для разработчиков и будущую поддержку платформ.
Когда я увижу результаты? Классический эффект SEO в Google проявляется за недели-месяцы. "Цитирование" в AI-системах ответов более непредсказуемо: некоторые платформы сканируют и используют новый контент в течение нескольких дней, у других это происходит гораздо медленнее. Дать точный график сейчас невозможно; эта область слишком нова.
Стоит ли внедрять WebMCP уже сейчас? Пока нет, но стоит следить за развитием. Спецификация все еще на стадии черновика, а поддержка браузерами ограничена.
Каким ботам нужно разрешить доступ в robots.txt? Это зависит от того, на каких платформах вы хотите быть видимыми: GPTBot и OAI-SearchBot (OpenAI), ClaudeBot (Anthropic), PerplexityBot (Perplexity), Google-Extended (AI-функции Google). Убедитесь, что вы случайно не блокируете ни одного из них.
Контрольный список внедрения
- Добавьте на каждую страницу четкий, однострочный абзац-определение/резюме (в первых 100 словах)
- Добавьте блок FAQ с разметкой схемы
FAQPage(не менее 4-5 вопросов) - Добавьте видимую дату "последнее обновление" к статьям блога
- Убедитесь, что критически важный контент можно прочитать и без JavaScript (проверьте через view-source)
- Добавьте в
robots.txtявные строки разрешения для GPTBot, ClaudeBot, PerplexityBot, Google-Extended, OAI-SearchBot - Создайте файл
llms.txt, не ожидая чуда для SEO, помня о разделе "почему" выше - Добавьте на сайт схемы
Article,OrganizationиDefinedTerm - Возьмите WebMCP на заметку и запланируйте пилотную оценку во второй половине 2026 года
- Создавайте оригинальные данные и кейсы (результаты "до и после"): только их никто не сможет скопировать
В заключение: эта статья применяет собственные советы
Блоки с определениями, заголовки в формате вопрос-ответ, сравнительная таблица, примеры кода и видимая дата "последнее обновление", которые вы только что прочитали, представляют собой живое применение техник GEO, рекомендуемых в этой статье. Следующий шаг: опубликовать ее; через несколько недель вы сможете проверить логи сервера и увидеть, заходили ли к вам GPTBot, ClaudeBot и PerplexityBot.
Если вы хотите работать с нами над GEO, посмотрите страницу услуги GEO, а если нужен её аналог в классическом поиске, откройте страницу услуги SEO.
Как мы измеряем эту видимость, мы рассказываем в статье Измерение видимости в AI; о том, как ИИ-агенты используют сайты, читайте в статье WebMCP, а о влиянии нулевого клика на органический трафик читайте в статье Эпоха нулевых кликов; технические основы описаны на странице llms.txt.
Похожие услуги
Похожие технологии