GEO - تحسين محركات البحث التوليدية
محركات الذكاء الاصطناعي لا ترتب بل تختار المصادر. نجعل موقعكم قابلا للاقتباس عبر llms.txt والبيانات المنظمة وإشارات E-E-A-T وبروتوكول WebMCP وسياسة الزواحف.
محركات الذكاء الاصطناعي لا ترتب الصفحات. فهي حين تولد جوابا عن سؤال تختار بنفسها أي المصادر تقرأ، ثم تمزج جملا مأخوذة منها في جوابها الخاص، وتضع تحته في الغالب بضعة روابط. ولهذا لا يكون الهدف «المرتبة الثالثة» بل أن تكون المصدر الذي يذكر اسمه داخل ذلك الجواب. وشروط ذلك تختلف عن شروط الترتيب الكلاسيكي: على النموذج أن يجد الصفحة، وأن يفهم موضوعها بلا تخمين، وأن يبقى ما يأخذه صحيحا حين ينتزع منها فقرة واحدة. وعمل Detartech في مجال GEO، أي تحسين محركات البحث التوليدية، ينحصر في بناء هذه الشروط الثلاثة في الموقع واحدا واحدا. وقد فعلنا الشيء نفسه في موقعنا نحن، ولهذا يمكن فتح أكثر ما في هذه الصفحة من دعاوى والتحقق منه على موقع detartech.com مباشرة.
كيف نعرّف GEO
اختصار GEO يقابل generative engine optimization، أي إعداد الموقع ليصلح مصدرا للأنظمة التي تولد الأجوبة مثل ChatGPT وPerplexity وGoogle AI Overviews وغيرها. والعمل طبقتان. الأولى قابلية القراءة آليا: أن يجد النموذج وزاحفه الموقع، وأن يعرفا ما هي كل صفحة، وألا يضطرا إلى التخمين وهما يحللان المحتوى. والثانية قابلية الاقتباس: أن تبقى الفقرة صحيحة وتامة وقابلة لنسبتها إلى مصدرها بعد انتزاعها من الصفحة. وهناك ما لا نفعله: لا ندس تعليمات خفية للنموذج، ولا نكتب نصا لا يراه الزائر، ولا نخترع أسماء كتاب ولا تواريخ. فهذا كله مخالف لإرشادات محركات البحث، وهو أسرع طريق إلى فقد إشارة الثقة نفسها التي نسعى إليها. ولمن أراد كيف تعمل محركات الأجوبة وما خارطة الطريق التقنية فقد كتبنا ذلك في دليل GEO لدينا.
كيف نفتح الموقع لمحركات الذكاء الاصطناعي
تغطي العناوين الستة التالية كل ما يدخل في عمل GEO عندنا. الأولان طبقة الاكتشاف وطبقة المعنى: ملفات مقروءة آليا يجد النموذج بها الموقع، وبيانات منظمة لا تترك التباسا في هوية الصفحة. والثالث يجيب عن سؤال من المتكلم، والرابع يحدد أي زاحف يدخل ولأي غرض. والخامس يخص النص نفسه، أي صلاحية الفقرة للاقتباس وحدها. أما السادس فيتجاوز القراءة إلى الفعل: أدوات يقدمها الموقع للوكلاء الذين ينفذون عمليات عليه. ومعظم المشاريع تبدأ بالعناوين الخمسة الأولى.
ملف llms.txt وخريطة الموقع المقروءة آليا
ملف llms.txt فهرس بصيغة markdown يوضع في جذر الموقع ويدل النموذج على العناوين التي ينظر فيها وهو يقرأ. ويكتب داخله لا نسخة من القائمة بل عناوين موجودة فعلا، ومعها سطر واحد يبين ما في كل عنوان منها؛ ويكفي عنوان واحد غير موجود ليصير الملف كله غير جدير بالثقة. وفي الطبقة نفسها تقع نقاط JSON الطرفية مثل قائمة الخدمات وملف الأسئلة الشائعة وكتالوج الواجهات البرمجية، وهي المواضع التي تحصل فيها الآلة على الجواب من غير أن تحلل صفحة كتبت للإنسان. أما في خريطة الموقع فأكثر ما نصلحه هو الطزاجة المزيفة، أي رفع قيمة lastmod في كل الصفحات إلى تاريخ اليوم عند كل نشر، وهي عادة تفرغ معلومات التواريخ في الموقع كله من معناها خلال أسابيع. وبدل انتظار زحف جديد على صفحة تغيرت نخبر عنها عبر بروتوكول IndexNow مباشرة.
البيانات المنظمة بمعيار Schema.org
البيانات المنظمة كتلة بصيغة JSON-LD تصف للآلة ما هي الصفحة. ونستعمل Organization لبيانات الشركة، وWebSite للموقع كله، وArticle لمقالة المدونة، وHowTo للشرح خطوة خطوة، وFAQPage لكتلة الأسئلة والأجوبة، وBreadcrumbList لمسار التنقل. والجزء غير المرئي من العمل هو ربط الهوية: فما لم يربط اسم الشركة في الموقع وعنوانها وحساباتها في المصادر الخارجية بخاصية sameAs فقد يظن النموذج أن الحديث عن كيانين مختلفين. وثمة قاعدة واحدة لا تقبل المساومة: يجب أن تطابق البيانات المنظمة النص الظاهر في الصفحة. ووسم أسئلة غير موجودة في الصفحة بوسم FAQPage يجلب عقوبة لا ظهورا. ونمرر كل مخطط على أداة تحقق قبل النشر، لأن حقلا واحدا معطوبا قد يجعل الكتلة كلها غير مقروءة.
إشارات E-E-A-T
يرمز E-E-A-T إلى الخبرة والاختصاص والسلطة والموثوقية، وهي الإشارات التي تعتمد عليها محركات البحث لتقدير مدى الثقة بالمحتوى. وتسير الأنظمة المولدة للأجوبة على منطق مشابه، فتنظر في هوية القائل قبل أن تقتبس جملته. ولذلك تحال صفحة الكاتب إلى شخص حقيقي وإلى اختصاصه الحقيقي وإلى وسيلة للتواصل معه، ويكتب تاريخ النشر وتاريخ التحديث بصدق، وإذا استند الادعاء إلى مصدر خارجي ذكر ذلك المصدر صراحة داخل النص. وعلى صعيد الشركة يبقى الاسم القانوني والعنوان وبيانات التواصل على صيغة واحدة في كل صفحة، لأن اسم شركة يكتب في كل موضع على نحو يضعف إشارة الهوية. وجزء من العمل تحت هذا العنوان ليس علينا بل عليكم: فمن غير كتاب حقيقيين وخبرة حقيقية وحالات قابلة للتحقق لا تصنع هذه الإشارات.
سياسة وصول زواحف الذكاء الاصطناعي وملف robots.txt
ملف robots.txt هنا ليس تفصيلا تقنيا بل قرارا تجاريا: أي زاحف يدخل موقعكم ولأي غرض. ولا بد من الفصل بين ثلاث فئات. فئة تجمع المحتوى لتدريب النماذج، وفئة تغذي فهرس البحث، وفئة تفتح الصفحة نيابة عن المستخدم في اللحظة التي يسأل فيها. وإغلاق زاحف التدريب مع إبقاء الزاحف الذي يأتي وقت الجواب مفتوحا موقف متسق؛ أما إغلاق الفئات الثلاث معا فيغلق كذلك احتمال الظهور في الأجوبة. ونتخذ القرار كتابة أولا، ثم نكتب القواعد باسم كل زاحف على حدة، لأن سياسة تترك لقاعدة النجمة تجعل السؤال عمن وصل إلى ماذا موضع جدال لاحقا. وثمة تنبيه: ملف robots.txt ليس دائما الملف الذي كتبتموه أنتم. فالكتل المدارة التي تضيفها طبقة الشبكة قد تقع فوق قواعدكم، ولذلك نتحقق من السياسة من الملف المنشور لا من المستودع.
معمار الفقرات القابلة للاقتباس
لا يأخذ محرك الأجوبة الصفحة كاملة بل ينتزع منها قسما واحدا. ولذلك يجب أن تكفي الكتلة تحت كل عنوان نفسها: يعطى الجواب في الجملة الأولى، ويسبق التعريف التفصيل، ويقف الرقم في الجملة نفسها مع وحدته وتاريخه، ولا تستعمل الإحالات إلى الوراء من نوع «كما شرحنا أعلاه» أبدا. والمعيار بسيط: انزعوا الفقرة من الصفحة واقرأوها وحدها، أتبقى صحيحة مفهومة؟ فإن لم تبق فلن تدخل تلك الفقرة في جواب قط. وتكتب كتلة الأسئلة الشائعة بالمنطق نفسه، فيؤخذ فيها السؤال الذي يطرحه المشتري فعلا لا سؤال تزييني تسويقي. وهذه الصفحة نفسها بنيت على هذه القاعدة.
بروتوكول WebMCP والوكلاء الذين يستعملون الموقع
لم يعد الوكلاء يقرأون المواقع فحسب بل ينفذون عليها عمليات. وبروتوكول WebMCP طريقة يقدم بها الموقع للوكيل الزائر أدوات تستدعى مباشرة بدل نص يحلله. وفي موقعنا نحن لا تعرف هذه الأدوات مرة ثانية يدويا: بل يأخذ الوكيل في المتصفح قائمة الأدوات من نقطة MCP الطرفية الخاصة بالموقع، فيستحيل أن يفترق السطحان. وكل الأدوات المسجلة للقراءة فقط. أما نموذج التواصل ونموذج طلب العرض فيبقيان مفتوحين بوصفهما أداتي نموذج تصريحيتين، فيظل الإنسان أمام النموذج قبل الإرسال. ويخبر كتالوج الواجهات البرمجية بمعيار RFC 9727 الآلات على حدة بما هو موجود من واجهات. ولنكن صريحين: لا يعمل بروتوكول WebMCP اليوم إلا في متصفح Chrome وفي طور تجريبي، ولذلك لا نبيعه وعدا بحركة زوار بل نبنيه طبقة تهيئ واجهة الغد من اليوم. والتفصيل في مقالتنا عن WebMCP على مدونتنا.
الفرق بين GEO وSEO وموضع التقائهما
يتنافس SEO على مرتبة في قائمة من عشرة روابط زرقاء، بينما يتنافس GEO على أن يكون بين المصادر القليلة التي يقرأها النموذج وهو يركب جوابه. والتقاطع بينهما أوسع مما يظن: قابلية الزحف، وسرعة الصفحة، وسلامة HTML، وخريطة موقع نظيفة، وربط داخلي معقول، ومحتوى يحمل معلومة فعلا، أرضية مشتركة للطرفين. والموقع الذي لا يراه Googlebot لا تراه في الغالب زواحف الذكاء الاصطناعي أيضا، ولهذا لا نقدم GEO بديلا من SEO بل مكملا له. ويبدأ الافتراق في موضعين. الأول وحدة العمل: يحسن SEO الصفحة ويحسن GEO الفقرة، فالفاصل ليس كثافة الكلمات المفتاحية بل تمام الفقرة وحدها. والثاني النتيجة: جواب الذكاء الاصطناعي قد يشبع المستخدم من غير نقرة، فيكف عدد الجلسات وحده عن كونه مقياس نجاح. أما العمل التقني ومعمار المحتوى في جانب البحث الكلاسيكي فخدمة مستقلة شرحناها في صفحة SEO لدينا.
كيف نقيس الظهور
نقسم القياس إلى أربع طبقات. الأولى الزحف: تبين سجلات الخادم وشبكة التوزيع أي زاحف ذكاء اصطناعي سحب أي العناوين، وبأي وتيرة، وبأي رمز استجابة، وهذه الطبقة سجل لا تقدير. والثانية الاقتباس: تشغل قائمة أسئلة ثابتة تخص عملكم على محركات الأجوبة في مواعيد منتظمة، ويسجل هل ورد اسم العلامة في الجواب وهل أعطي له رابط. والثالثة الإحالة: تتابع في التحليلات حركة الزوار الآتية من محركات الأجوبة شريحة مستقلة. والرابعة التحويل: نتتبع هل ملأت تلك الجلسات نموذجا وهل طلبت عرضا. ونقول حد الطبقة الثانية سلفا: الأجوبة تتغير بحسب المستخدم والجلسة والمنطقة وإصدار النموذج، فالذي نقيسه ليس مرتبة بل اتجاها يقرأ من تشغيلات متكررة. وكيف تبنى لوحة المتابعة وأي مؤشرات نرصد فصلناه في مقالتنا عن قياس الظهور.
العوامل التي تحدد النتيجة
إجابة محرك الإجابات على السؤال نفسه ليست ثابتة: فهي تتغير بحسب المستخدم والجلسة والمنطقة ونسخة النموذج العاملة في تلك اللحظة. وقد يصل تغيير ما إلى الزواحف التي تسحب الصفحة وقت الجواب خلال أيام، أما دخول التغيير نفسه إلى النموذج المدرب فيتوقف على دورة إصدار ذلك النموذج. وبسبب هذا التغير نبني القياس بوصفه عملية متكررة منتظمة لا فحصا لمرة واحدة: تُشغَّل قائمة أسئلة ثابتة على فترات محددة، وتُقرأ النتيجة بوصفها اتجاها عبر التشغيلات المتكررة لا لقطة آنية. والوسوم أيضا لا تغيّر هذه الآلية، بل تسهّل فقط على النموذج قراءة معلومة موجودة أصلا؛ فإن لم تحمل الفقرة ما لا تحمله عشرون صفحة أخرى فلن يجعلها أي مخطط بيانات وحده قابلة للاقتباس.
كيف يسير عمل GEO
يبدأ العمل بتدقيق. ننظر فيما هو منشور فعلا: ملف robots.txt، وخريطة الموقع، وملف llms.txt، وهل تجتاز البيانات المنظمة التحقق، وهل لنا وصول إلى سجلات الزواحف، وأي الأسئلة ستقاس. والناتج قائمة مكتوبة مرتبة بحسب الكلفة والأثر، وهي وحدها عمل قابل للتسليم تستطيعون أن تنفذوه بفريقكم. والمرحلة الثانية التنفيذ: تدخل الملفات والوسوم في مستودعكم وعلى نطاقكم أنتم، لا في وسيط قائم على خوادمنا. ونسير بدورات من أسبوعين، ويرفع في نهاية كل دورة تقرير يجمع ما نشر من تغييرات مع نتيجة القياس. والمرحلة الثالثة القياس: يؤخذ قياس أساس قبل التنفيذ، وتعاد قائمة الأسئلة نفسها بعده. وحين ينتهي العمل لا يتوقف شيء: يبقى ملف llms.txt والبيانات المنظمة وقواعد robots في موقعكم، وتسلم لكم قائمة الأسئلة وجدول القياس.
خطط GEO الشهرية
لا ينتهي عمل GEO كمشروع لمرة واحدة، لأن محركات الإجابة والنماذج ومحتوى المنافسين تتغير كل شهر. لذلك نواصل العمل بعد التدقيق والجولة الأولى من التنفيذ ضمن خطة شهرية. هناك ثلاث خطط، وكل واحدة منها مبنية على التي قبلها. يتوقف اختيار الخطة المناسبة على قدرة فريقكم على تنفيذ النتائج بنفسه، وعلى رغبتكم في ربط الطلب القادم من البحث بالذكاء الاصطناعي بالمبيعات. نطاق كل خطة ثابت، أما السعر فيحدد في عرض بحسب حجم الموقع وعدد اللغات وعدد الأسئلة المتابعة.
المتابعة: نقيس ونرفع التقارير
- تدقيق أولي وتسجيل خط أساس تقارن به كل القياسات اللاحقة
- قائمة أسئلة ثابتة خاصة بنشاطكم تقاس كل شهر بتشغيلات متكررة على ChatGPT وPerplexity وGemini وGoogle AI Overviews
- حصة الظهور في الإجابات، وقائمة بالأسئلة التي يستشهد فيها بالمنافسين دونكم
- متابعة ثلاثة منافسين تختارونهم على الأسئلة نفسها وفي البحث التقليدي
- قراءة سجلات الخادم وشبكة CDN لمعرفة الصفحات التي تجلبها زواحف الذكاء الاصطناعي ومعدل ذلك
- متابعة الزيارات القادمة من محركات الإجابة كشريحة مستقلة في GA4 وSearch Console
- تقرير شهري يرتب النتائج بحسب الكلفة والأثر
المتابعة والتنفيذ: نقيس ونصلح
كل ما في خطة المتابعة، مع تنفيذ النتائج من جهتنا. هذا هو الفرق عن خدمة تكتفي بتسليم التقارير: الثغرة التي تظهر في تقرير تظهر مغلقة في التقرير التالي.
- سعة هندسية ثابتة كل شهر لتنفيذ النتائج في مستودعكم: البيانات المنظمة وllms.txt وسياسة robots.txt وخريطة الموقع وIndexNow
- إعادة صياغة المقاطع في الصفحات المرتبطة بالأسئلة التي لا يستشهد بكم فيها بحيث يمكن اقتباسها منفردة، وتنظيم الروابط الداخلية
- فحص تقني شهري: PageSpeed ومؤشرات Core Web Vitals والروابط المعطلة وأخطاء الفهرسة وإعادة التوجيه
- تحديث دليل أو دليلين أو كتابتهما من جديد كل شهر
النمو: نقيس ونصلح ونربط بالإيرادات
كل ما في خطة المتابعة والتنفيذ، مع بناء المرجعية خارج الموقع وربط الطلب القادم من البحث بالذكاء الاصطناعي بالمبيعات. جزء كبير من الصفحات التي تستشهد بها محركات الإجابة ليس موقع العلامة نفسه، لذلك تمتد هذه الخطة إلى خارج موقعكم.
- إنشاء ملفات تعريفية وتحديثها بمعلومات مشاريع حقيقية في الأدلة والمنصات التي تستشهد بها محركات الإجابة كثيرا
- عملية لاقتراح مقالات وآراء متخصصة على المنشورات القطاعية
- إدارة ملف Google Business وعملية لطلب مراجعات العملاء دون أي حافز
- تتبع الجلسات القادمة من محركات الإجابة حتى النموذج ونظام CRM والعرض؛ ويبنى هذا الجزء على بنية RevOps لدينا
- تقرير شهري بعنوان "أي محرك، كم طلبا، أي عروض" واجتماع استراتيجي كل ثلاثة أشهر
ما تشترك فيه كل الخطط
يتكون التقرير الشهري في كل الخطط من أربعة أقسام: ما أنجز هذا الشهر، والظهور في الذكاء الاصطناعي وأداء البحث، ووضع المنافسين، وخطة الشهر القادم. يخصص الشهر الأول لإعداد الصلاحيات وتسجيل خط الأساس، وتصبح المقارنة ذات معنى من الشهر الثاني. وفي نهاية الشهر الثاني عشر يعاد التدقيق من البداية وتوضع النتيجة إلى جانب خط الأساس من اليوم الأول. لا تتضمن أي خطة ضمانا للظهور في إجابة بعينها؛ ما تحصلون عليه هو سجل مكتوب كل شهر لما قيس وما تغير وما أنجز.
لمعرفة الخطة المناسبة لكم يمكنكم البدء بتحليل أولي مجاني: نشغل عشرة أسئلة عن علامتكم على أربعة محركات إجابة ونرسل إليكم كتابيا أين يستشهد بكم، وأين يظهر المنافسون بدلا منكم، وأكبر ثلاث ثغرات تقنية. يمكنكم إرسال طلبكم عبر نموذج عرض السعر السريع.
ما يمكن التحقق منه من الخارج
كل بند مما يلي يعمل الآن ويمكن التحقق منه من الخارج.
- detartech.com، الطبقة المقروءة آليا: ملف llms.txt وكتالوج الواجهات البرمجية بمعيار RFC 9727 وملف ai/service.json وملف .well-known/ai.txt كلها منشورة. وفوق ذلك ترد الصفحة نفسها بصيغة markdown بدل HTML لمن يطلبها بهذه الصيغة من العملاء البرمجيين.
- detartech.com، واجهة الوكلاء: تسجل أدوات WebMCP من قائمة أدوات نقطة MCP الطرفية الخاصة بالموقع، وكلها للقراءة فقط. ونموذج التواصل ونموذج طلب العرض مفتوحان بوصفهما أداتي نموذج تصريحيتين، فيبقى الإنسان أمام النموذج قبل الإرسال.
- SanalRandevu: فيه ملف llms.txt، وقواعد robots.txt تسمي 18 زاحف ذكاء اصطناعي واحدا واحدا، وبيانات منظمة من نوع Organization وWebSite وHowTo، وفهرسة سريعة عبر بروتوكول IndexNow أيضا.
- bebekistiyorum.com: أرشيف محتوى يزيد على 1200 عنوان في 4 لغات جرى تحسينه للبحث الكلاسيكي ولتجارب البحث بالذكاء الاصطناعي مثل ChatGPT وPerplexity كذلك.
أبرز المزايا
- ملف llms.txt ونقاط طرفية مقروءة آليا ونظافة صادقة في خريطة الموقع
- بيانات منظمة بمعيار Schema.org تطابق النص الظاهر في الصفحة
- إشارات E-E-A-T مبنية على هوية الكاتب والمصادر والتواريخ
- سياسة وصول لزواحف الذكاء الاصطناعي في robots.txt بحسب الغرض
- معمار فقرات مكتوب ليقتبس كل جزء منه وحده
- قياس من أربع طبقات: الزحف والاقتباس والإحالة والتحويل
- ثلاث خطط شهرية بنطاق ثابت: المتابعة، والمتابعة والتنفيذ، والنمو
الأسئلة الشائعة
كم يستغرق عمل GEO وكيف يسعر؟
أي خطة GEO شهرية أختار؟
هل تضمنون ظهورنا في أجوبة ChatGPT وPerplexity وأمثالهما؟
ماذا نسلّم حين ينتهي العمل؟
عندنا عمل SEO قائم، فهل نحتاج إلى GEO مستقلا؟
ألا يمكن أن نمنع زواحف الذكاء الاصطناعي كلها؟
هل نحتاج إلى بروتوكول WebMCP في موقعنا؟
أين نقدم هذه الخدمة
- تهيئة المحتوى التركي لمحركات الذكاء الاصطناعي
- تهيئة العلامات التجارية في إسطنبول لمحركات الذكاء الاصطناعي
- تهيئة المنتجات الدولية في فيتن لمحركات الذكاء الاصطناعي
- تهيئة المنصات التعليمية في سوليهل لمحركات الذكاء الاصطناعي
- تهيئة المواقع متعددة اللغات في ألمانيا لمحركات الذكاء الاصطناعي
- تهيئة المؤسسات الصحية في بورصة لمحركات الذكاء الاصطناعي
- تهيئة شركات مرسين لمحركات الذكاء الاصطناعي
- تهيئة العلامات البريطانية لمحركات الذكاء الاصطناعي
 تهيئة المحتوى التركي لمحركات الذكاء الاصطناعي
 تهيئة المنتجات الدولية في فيتن لمحركات الذكاء الاصطناعي
 تهيئة المنصات التعليمية في سوليهل لمحركات الذكاء الاصطناعي
كيف نقدّم هذه الخدمة
التقنيات التي نستخدمها
عرض الكل
llms.txt
ملف نصي قياسي يُضاف إلى الدليل الجذري ليتمكن نماذج الذكاء الاصطناعي من فهم الموقع بشكل أفضل. النظير الخاص بالذكاء الاصطناعي لملف robots.txt المعروف.
OpenAI
المنصة لبناء تطبيقات الذكاء الاصطناعي المؤسسية عبر واجهات GPT-4o وo1 وEmbeddings البرمجية. وصول بواجهة برمجة واحدة إلى نماذج النصوص والأكواد والصور والصوت.
Perplexity
محرك بحث ذكاء اصطناعي يجري بحثا فوريا على الويب مع الاستشهاد بالمصادر. منصة أساسية للظهور في استراتيجية GEO، ويمكن دمجه في التطبيقات عبر واجهة Sonar API البرمجية.
مشاريع أخرى
عرض الكل
Paşa Yapı Tasarım - موقع مؤسسي لحلول الواجهات والديكور
موقع مؤسسي ثنائي اللغة (TR/EN) لشركة Paşa Yapı Tasarım في إسطنبول، المتخصصة في الواجهات والديكور الداخلي والأسقف والأرضيات منذ 1992. يضم 22 صفحة تطبيقات ومعالج عروض أسعار من 6 خطوات وكتالوجًا إلكترونيًا وبنية SEO جاهزة للبحث بالذكاء الاصطناعي.

bebekistiyorum.com - موقع متعدد اللغات لمركز أطفال الأنابيب مع SEO وGEO
أعيد بناء موقع مركز Eurofertil لأطفال الأنابيب بتقنية Next.js وبأربع لغات: تم الحفاظ على أكثر من 1200 رابط عبر تحويلات 301، مع بنية كاملة لـ SEO وGEO تخدم محركات البحث وإجابات الذكاء الاصطناعي.
يوكبرو - منصة إعلانات الشحن والنقل
حوّلنا النموذج الأولي لتطبيق Yükpro المدعوم بالذكاء الاصطناعي، وهو منصة تربط أصحاب الحمولات بالناقلين، إلى MVP جاهز للإنتاج وأطلقناه على iOS وAndroid.
مقالات ذات صلة
ChatGPT Ads متاح الآن في تركيا: كيف انتشرت إعلانات OpenAI من الولايات المتحدة إلى 56 دولة وكيف تعلن عبرها
فُتح نظام إعلانات OpenAI في تركيا يوم 16 سبتمبر 2026. الجدول الزمني، شكلا chat_card وSponsored Agents، أسعار CPM/CPC، وقائمة تحقق لفتح الحساب.
عصر النقرة الصفرية: كيف تغيّر AI Overviews الزيارات العضوية؟
أكثر من ثلثي عمليات البحث على Google في الولايات المتحدة تنتهي الآن دون نقرة. هذا لا يعني نهاية SEO، لكنه يعني أن عليك تغيير ما تقيسه.
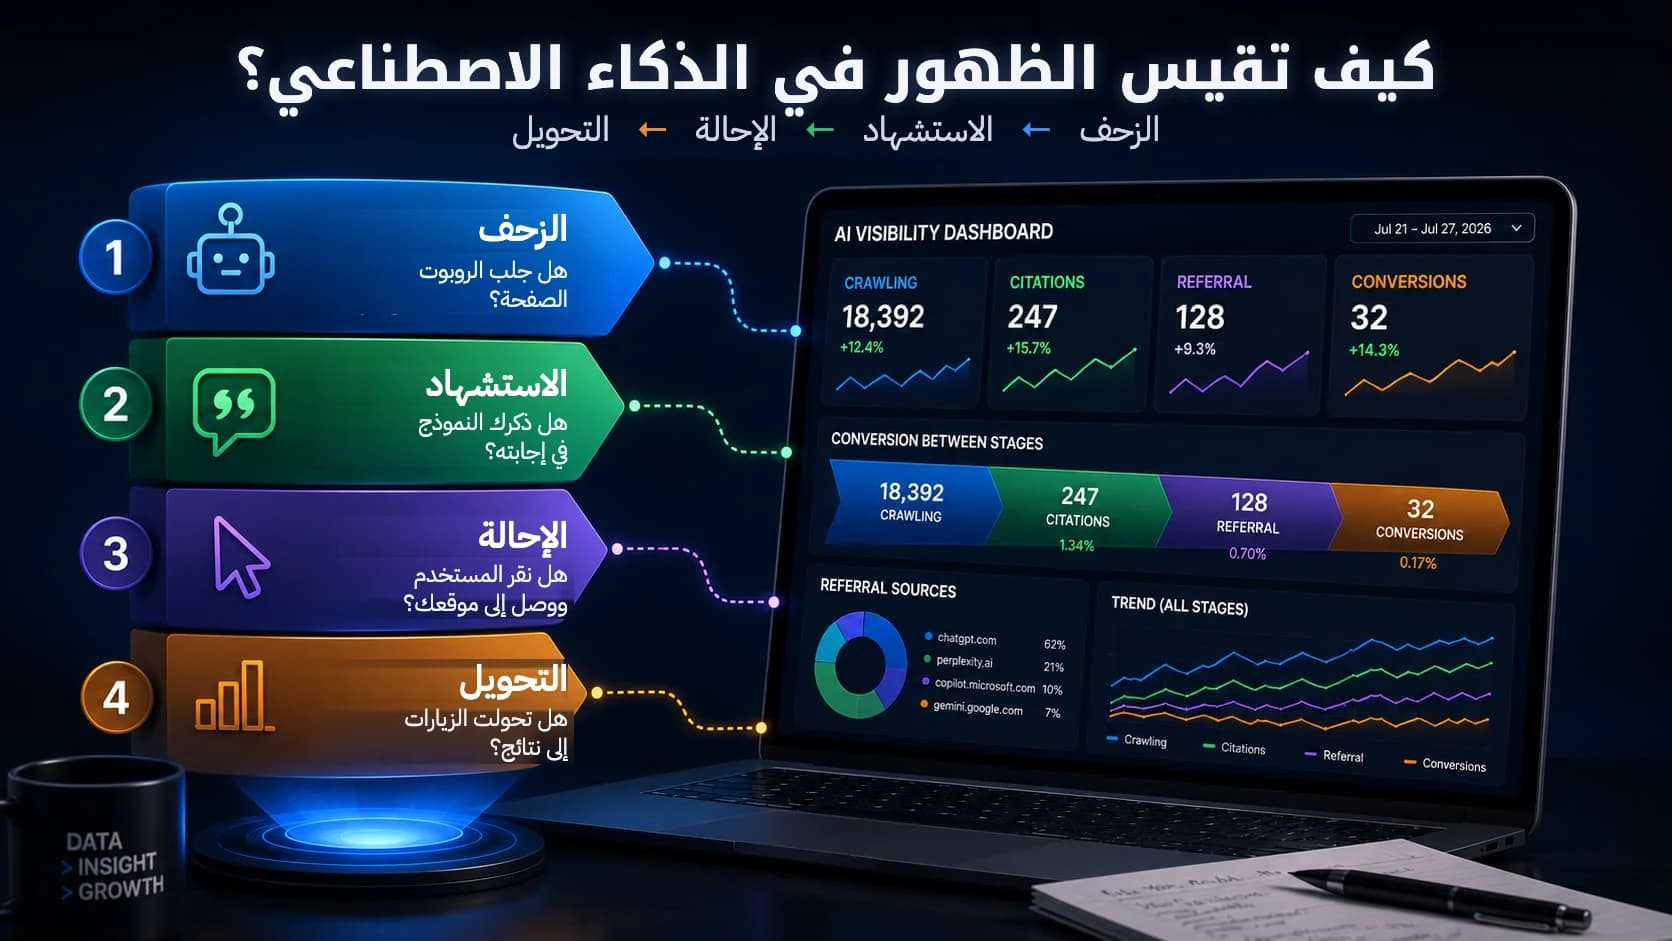
قياس الظهور في الذكاء الاصطناعي: مؤشرات GEO ولوحة المراقبة
هل تظهر في إجابات الذكاء الاصطناعي، وكيف تعرف ذلك؟ مؤشرات GEO عبر أربع طبقات: الزحف والاستشهاد والإحالة والتحويل، مع كيفية بناء لوحة المراقبة.
دليل GEO لمحركات البحث بالذكاء الاصطناعي: خارطة طريق تقنية للظهور في ChatGPT وPerplexity وGemini
ما هو GEO (تحسين المحرك التوليدي) وما الفرق بينه وبين SEO؟ هل يعمل ملف llms.txt فعلا؟ دليل تقني لعام 2026 مع Schema.org وWebMCP وأمثلة برمجية جاهزة للنسخ واللصق.
WebMCP: عندما تستخدم وكلاء الذكاء الاصطناعي موقعك بالحديث لا بالنقر
السطر الذي لاحظته في اختبار PageSpeed بعبارة "agentic browsing" تبيّن أنه باب يفتح على مستقبل الويب. ما هو WebMCP، وما الفرق بينه وبين MCP، ولماذا يجب أن تهتم بهذا الأمر من الآن من منظور SEO وGEO؟ أشرح الموضوع بعين تقنية، مع أمثلة برمجية.
لنتحدث عن مشروعك
كيف يمكننا تطبيق هذه الخدمة على مشروعك؟
املأ نموذج طلب العرض للحصول على استشارة مجانية لمدة 30 دقيقة.