Построить ИИ-систему, соответствующую GDPR, значит заранее, на уровне архитектуры, решить, куда уходят персональные данные, кто их видит и сколько они хранятся. В RAG- и агентных системах на эти три вопроса отвечают не в одном месте, а на каждой остановке, через которую проходят данные: когда документ режется на фрагменты и превращается в векторы, когда результаты поиска отправляются модели, когда ответ попадает в журнал и когда агент выполняет действие в другой системе. Если на каждой из этих остановок граница данных не зафиксирована письменно, даже проект с лучшими намерениями приходит к потоку данных, который трудно объяснить надзорному органу или аудитору.
Статья предназначена для технических руководителей, владельцев продукта и специалистов по защите данных, которые планируют внутреннего RAG-ассистента или ИИ-агента, работающего с корпоративными системами и обрабатывающего персональные данные людей в ЕС. Мы разбираем, какие инженерные решения нужно принять и каких понятий GDPR они касаются. Это не юридическая консультация: обязательства в вашей конкретной ситуации всегда уточняйте у юриста или ответственного за защиту данных (DPO). Компании, работающие в Турции, сталкиваются с похожими вопросами в рамках KVKK, турецкого закона о защите данных: его принципы близки, но не идентичны.
Почему GDPR становится отдельной темой проектирования в ИИ-проектах?
В классическом веб-приложении персональные данные обычно лежат в известных таблицах и известных полях. В ИИ-системах данные меняют форму и множатся. PDF делится на фрагменты, каждый фрагмент становится вектором, отобранные поиском фрагменты попадают в промпт, промпт уходит к поставщику модели, а ответ, часто вместе с самим промптом, записывается в журнал. За несколько секунд одни и те же персональные данные оказываются в четырёх местах и в четырёх формах.
Поэтому базовые принципы статьи 5 GDPR остаются прежними, но применять их становится сложнее:
- Минимизация данных: в документах могут быть имена клиентов, идентификационные номера, сведения о здоровье, оценки сотрудников. Большинство организаций замечает это не при загрузке документов, а при первом неверном ответе.
- Ограничение цели: данные, собранные для исполнения договора или обработки обращения, теперь используются для ответов ассистента. Совместимо ли новое использование с исходной целью, нужно оценить отдельно.
- Передача данных: если поставщик модели обрабатывает данные за пределами ЕС и ЕЭЗ, персональные данные внутри промпта переданы в третью страну.
- Ограничение хранения: у векторной базы, журналов промптов и собственных журналов поставщика разные сроки хранения, и редко кто рассматривает их вместе.
Через какие остановки проходят данные в RAG-системе?
Безопасность корпоративного RAG начинается с того, чтобы пройти путь данных по остановкам. В типичном RAG-потоке пять остановок, и у каждой свой риск.
- Система-источник: место, где хранятся документы (файловый сервер, система документооборота, CRM, почтовый архив). Риск: массовая загрузка документов вне согласованного объёма.
- Подготовка и нарезка: документы превращаются в текст и делятся на фрагменты. Риск: персональные данные обрабатываются без маскирования.
- Эмбеддинги и векторная база: фрагменты превращаются в векторы и сохраняются. Риск: модель эмбеддингов работает как внешний API, а фрагменты хранятся без метаданных о правах доступа.
- Поиск и сборка промпта: под вопрос пользователя отбираются фрагменты и отправляются модели. Риск: в ответ попадают фрагменты, которые пользователю видеть не положено.
- Модель и журналирование: формируется ответ, промпт и ответ записываются в журнал. Риск: бессрочное хранение журналов и использование данных поставщиком в собственных целях.
Если нарисовать этот список как схему потока данных и рядом с каждой остановкой написать «какие персональные данные, в какой стране, какой обработчик, кто имеет доступ, как долго», вы получите основу для реестра операций обработки по статье 30. Для технической и для правовой стороны проекта это самый ценный документ.
Является ли отправка данных поставщику модели передачей в третью страну?
Если промпт с персональными данными отправляется поставщику модели, который обрабатывает его за пределами ЕС и ЕЭЗ, это, как правило, передача в третью страну по главе V GDPR (статьи 44-49). Для передачи нужно правовое основание. Первое из них решение Европейской комиссии о достаточности уровня защиты в стране назначения. Для США таким маршрутом служит EU-US Data Privacy Framework для поставщиков, прошедших сертификацию; рамочное соглашение уже оспаривалось в суде, поэтому его актуальный статус стоит проверить у юриста, а не считать постоянным. Если решения о достаточности нет, нужны надлежащие гарантии: чаще всего стандартные договорные условия Еврокомиссии (SCC) вместе с оценкой последствий передачи либо обязательные корпоративные правила внутри группы компаний. Исключения статьи 49 узкие и не подходят как основание для регулярной обработки.
Отдельно от вопроса передачи: поставщик модели, обрабатывающий данные по вашему поручению, является обработчиком, и статья 28 требует договора с определёнными условиями. На инженерной стороне это означает, что в начале проекта нужно ответить на вопросы:
- Что сказано в соглашении об обработке данных (DPA) поставщика? Используются ли отправленные данные для обучения модели, и если нет, закреплено ли это письменно?
- В каком регионе поставщик обрабатывает и хранит данные? Можно ли выбрать регион в ЕС и распространяется ли это на доступ службы поддержки и субобработчиков?
- Сколько поставщик хранит промпты для контроля злоупотреблений? Можно ли сократить этот срок до нуля?
- Какой маршрут передачи применяется и кто поддерживает в актуальном состоянии SCC и оценку последствий передачи?
Правовой ответ на эти вопросы зависит от вашей собственной оценки как контролёра. Задача технической команды в том, чтобы собрать сведения, на которых эта оценка строится, и построить архитектуру, которую можно изменить под принятое решение. Не исходите из того, что «поставщик крупный, значит, всё в порядке», не подтвердив это у юриста.
Как очистить персональные данные до создания эмбеддингов?
Самые безопасные персональные данные те, что вообще не попали в систему: это минимизация данных, реализованная в коде. Чтобы RAG-ассистент ответил, ему редко нужны имя клиента или его номер; обычно достаточно самой процедуры, пункта договора или технического пояснения. Поэтому на этапе подготовки вместе применяются три приёма:
- Фильтр объёма: какие папки, типы документов и периоды попадают в систему, решается письменно. «Загрузим весь общий диск» самая частая ошибка при определении границы данных.
- Анонимизация: персональные данные, не нужные для ответа, удаляются из текста до создания эмбеддингов. Действительно анонимные данные выходят из-под действия GDPR, но планка высокая: если человека всё ещё можно установить средствами, применение которых разумно вероятно, данные не анонимны.
- Псевдонимизация: если связь с человеком нужна, а модели видеть её не обязательно, поля вроде имени и номера заменяются ключом. Таблица соответствия хранится отдельно с ограниченным доступом. Псевдонимизированные данные по GDPR остаются персональными, но до модели и поставщика доходит меньше, а сам регламент называет псевдонимизацию мерой безопасности.
Правил маскирования на одних регулярных выражениях недостаточно: имена, адреса и сведения о здоровье в свободном тексте не следуют шаблонам. На практике обнаружение по правилам сочетают с моделью распознавания сущностей и измеряют результат на выборке документов. Фраза «мы маскируем данные» без тестового набора, показывающего, сколько персональных данных пропущено, гарантией не является.
Как применять контроль доступа в момент поиска?
Самая коварная брешь в безопасности корпоративного RAG это ассистент, который показывает всем одни и те же документы. Если сотрудник без доступа к папке HR может спросить «какая у нас шкала зарплат» и получить ответ от ассистента, система фактически отключила модель прав документооборота, и требование конфиденциальности из статьи 32 уже не выполняется.
Правильный подход в том, чтобы применять права при поиске, а не после формирования ответа:
- Каждый фрагмент несёт в метаданных список доступа исходного документа (пользователь, группа или роль).
- Поисковый запрос фильтруется по личности и группам спрашивающего; фрагменты, на которые у него нет прав, не попадают даже в список кандидатов.
- Когда права меняются в системе-источнике, метаданные в векторной базе тоже обновляются. Задержка синхронизации измеряется и привязывается к письменной цели.
- Вместе с ответом показывается исходный документ; если пользователь не может открыть исходный документ, ответ не должен содержать сведений из него.
Инструкция модели «не раскрывай информацию, на которую у пользователя нет прав» контролем доступа не является. Если модель видела фрагмент, так или иначе он может просочиться в ответ. Права нужно применять на том уровне, который решает, какие данные дойдут до модели.
Как провести границу данных в агентных системах?
RAG-система читает, агент действует. Если агент может обновлять записи в CRM, отправлять письма или выполнять запросы к базе данных, риск по GDPR выходит за пределы чтения: отправка данных не тому адресату, несанкционированные изменения, действия без записи в журнале. Если агент без значимого участия человека принимает решения, которые порождают правовые или сопоставимо значимые последствия для людей, в игру вступает и статья 22 об автоматизированном принятии решений. Об агентах мы подробно писали в статье о выводе ИИ-агентов в продакшен; с точки зрения границы данных главные правила такие:
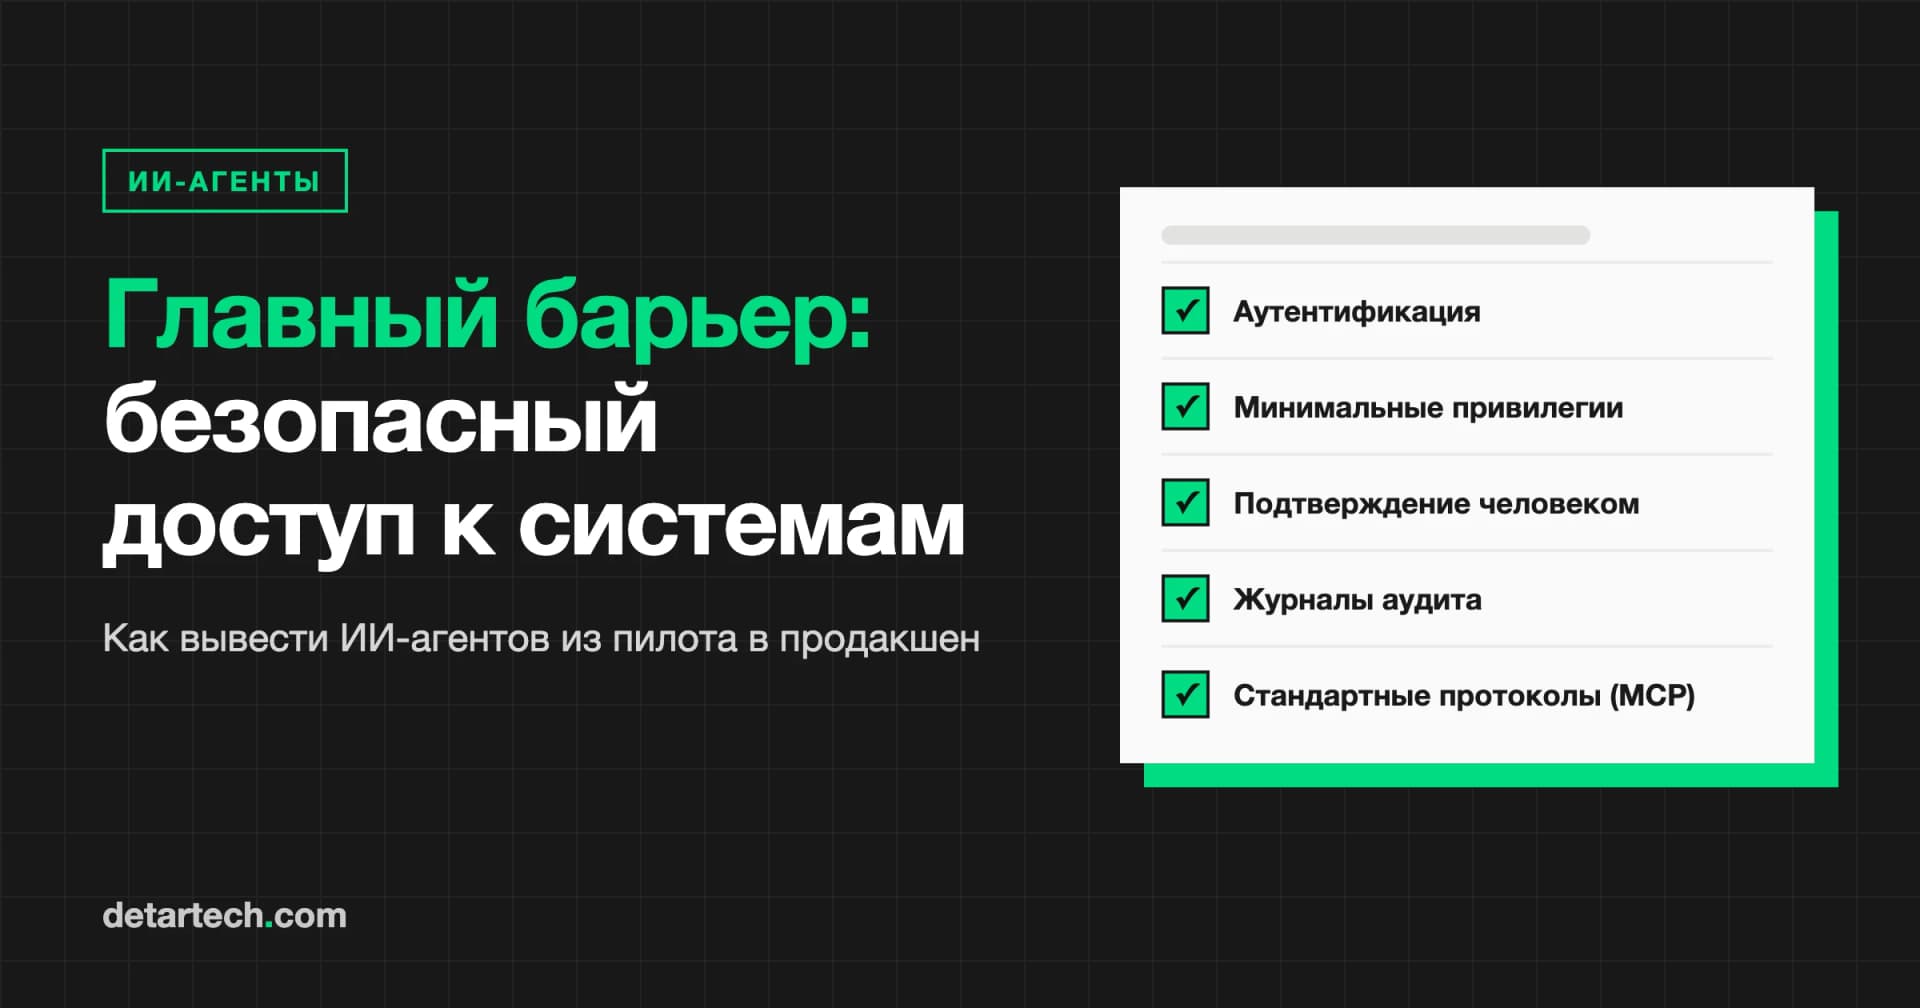
- Минимальные привилегии: агент работает с самыми узкими правами, нужными для его задачи. Если достаточно чтения, права на запись нет; если достаточно одной таблицы, доступа ко всей базе нет.
- Действие от имени пользователя: агент работает с правами пользователя, который запустил действие, а не со своей широкой сервисной учётной записью. Так агент не сможет сделать то, чего не мог бы сделать сам пользователь.
- Шлюзы подтверждения человеком: действия, которые отправляют данные наружу, удаляют записи, вносят массовые изменения или решают что-то о человеке, не выполняются без подтверждения человека.
- Границы на уровне инструментов: каждый инструмент агента определяет, что он может делать и какие поля возвращает. В протоколах вроде MCP настоящая ценность в том, что эти определения и слой авторизации над ними можно управлять централизованно.
Как определить журналирование и сроки хранения?
Журналирование в ИИ-системах находится между двумя противоположными потребностями. С одной стороны, запись того, какой пользователь что спросил, какие документы использовались и какое действие выполнил агент, нужна для отладки и для подотчётности по статье 5(2). С другой стороны, если полные тексты промптов хранятся бессрочно вместе с персональными данными внутри, хранилище журналов становится самым чувствительным набором данных организации и нарушает принцип ограничения хранения.
Сбалансированный подход выглядит так:
- Журнал аудита (кто, когда, какой документ, какое действие) хранится отдельно от журнала содержимого (полный текст промпта и ответа).
- Персональные данные в журналах содержимого маскируются, срок хранения короткий; по его истечении записи удаляются автоматически.
- Сроки хранения прописываются отдельно для векторной базы, журналов приложения, инструментов мониторинга и собственных журналов поставщика модели и сверяются с политикой хранения организации.
- Для запросов субъектов данных (доступ, исправление, удаление) заранее проектируется, как найти и обработать данные одного человека в векторной базе и журналах. Это одна из функций, которые труднее всего добавить потом.
Когда имеет смысл запускать модели с открытыми весами на своих серверах?
Самый ясный способ провести границу данных в том, чтобы данные вообще не покидали инфраструктуру, которую контролирует организация. Недавно выпущенные модели с открытыми весами достигли достаточного качества для многих корпоративных задач и могут работать на ваших серверах или в облачном регионе ЕС под вашим контролем. Этот вариант особенно стоит рассмотреть, если:
- в документах есть особые категории персональных данных по статье 9, например сведения о здоровье;
- отраслевое регулирование или договоры с клиентами требуют, чтобы данные оставались в определённой стране или в ЕС;
- объём использования достаточно велик и предсказуем, чтобы собственная инфраструктура обходилась дешевле API.
Цена тоже очевидна: эксплуатация, обновление, мониторинг и защита модели становятся вашей задачей, и часть возможностей самых сильных закрытых моделей может быть недоступна. Распространённый компромисс: шаги, работающие с чувствительными данными (эмбеддинги, классификация, маскирование), выполняются на своей инфраструктуре, а генерация по уже замаскированному содержимому отдаётся внешней модели. Архитектура, не привязанная к конкретной модели, это условие, при котором решение можно будет пересмотреть позже.
Как оценить риски до начала проекта?
По статье 35 оценка воздействия на защиту данных (DPIA) обязательна, если обработка может повлечь высокий риск для прав и свобод людей; типичные триггеры: новые технологии, масштабная обработка особых категорий данных и систематическая оценка людей. Многие ИИ-проекты подпадают хотя бы под один из них, а даже там, где DPIA формально не требуется, её подготовка остаётся хорошей практикой. Для ИИ-проекта она должна охватывать как минимум:
- цель обработки, правовое основание и категории данных, которые для неё действительно нужны;
- схему потока данных со страной, обработчиком и сроком хранения на каждой остановке;
- нужно ли обновить уведомление о конфиденциальности под новое использование;
- маршрут передачи и гарантии для любой обработки в третьих странах;
- модель контроля доступа и то, как она применяется при поиске;
- права агентов, действия, требующие подтверждения человеком, и любые автоматизированные решения;
- остаточные риски и тех, кто их принял.
Этот документ ценен не только для соответствия требованиям, но и для уточнения объёма проекта. Вопрос о том, какие данные действительно нужны, часто делает проект одновременно безопаснее и дешевле.
Чек-лист ИИ, соответствующего GDPR
- Есть схема потока данных, на каждой остановке указаны страна, обработчик и срок хранения, и она отражена в реестре операций обработки.
- Объём документов, попадающих в систему, определён письменно.
- Персональные данные маскируются до создания эмбеддингов, доля пропусков измеряется на тестовом наборе.
- DPA поставщика модели изучено; использование данных для обучения и сроки хранения понятны.
- Для обработки в третьих странах маршрут передачи (решение о достаточности, SCC, BCR) согласован с юристом.
- Контроль доступа применяется при поиске с учётом личности пользователя.
- Изменения прав в системах-источниках синхронизируются с векторной базой.
- Агенты работают с минимальными правами от имени пользователя; рискованные действия и решения о людях требуют подтверждения человеком.
- Журнал аудита и журнал содержимого разделены; срок хранения журнала содержимого короткий и соблюдается автоматически.
- Путь поиска и удаления данных одного человека во всех слоях спроектирован и проверен.
- При наличии особых категорий данных рассмотрен вариант модели на собственной инфраструктуре.
- DPIA или равноценная оценка рисков оформлена письменно, остаточные риски подписаны их владельцем.
Часто задаваемые вопросы
Нарушает ли GDPR отправка персональных данных в ChatGPT или похожий API? Сама по себе нет. Нужны правовое основание, договор с обработчиком по статье 28 и, если поставщик обрабатывает данные за пределами ЕС и ЕЭЗ, действующий маршрут передачи по главе V. То, как поставщик обрабатывает и хранит данные, следует закрепить договором. Свою ситуацию уточните у юриста.
Считаются ли векторы персональными данными? Векторы эмбеддингов это числовые представления текста, и некоторые методы позволяют восстановить сведения об исходном тексте. Кроме того, векторные базы часто хранят и сам фрагмент. Правильный подход: считать векторное хранилище персональными данными и защищать его так же тщательно, как исходные документы.
Выводит ли анонимизация из-под действия GDPR? Действительно анонимные данные выводит. Псевдонимизированные нет: они остаются персональными данными. Нужно уметь показать, что именно вы сделали, и проверить, можно ли ещё установить личность.
Решает ли всё модель с открытым кодом? Вопрос передачи в третьи страны в основном снимается, если модель размещена в ЕС, но правовое основание, контроль доступа, журналирование, сроки хранения, права субъектов данных и права агентов остаются. Где бы ни работала модель, границу данных определяет архитектура.
Если вы планируете RAG-ассистента или агентную систему, мы можем вместе описать поток данных и модель прав доступа. Как мы работаем, рассказано на странице услуги ИИ-решений, а вопросы к подрядчику собраны в руководстве о выборе компании для интеграции ИИ. Чтобы обсудить ваш проект, заполните форму быстрого запроса.